CNN이란?
- 합성곱 신경망은 주로 이미지 인식과 같은 컴퓨터 비전 분야를 데이터 분석하기 위해 사용되는 인공신경망의 한 종류
- 입력데이터의 지역적인 특징을 추출하는데 특화된 구조를 갖고 있으며, 이를 위해 "합성곱 연산"을 사용
CNN 용어 정리
1. 데이터 형태와 구조
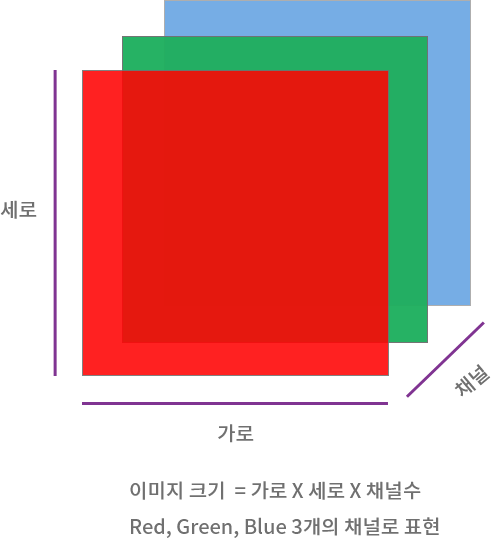
- 입력 : CNN 모델에 들어가는 최초의 데이터입니다. 이미지의 경우 가로, 세로 픽셀 크기와 색상 정보를 담은 '채널'로 구성된 3차원 형태의 데이터 형태
- 채널 (Channel) : 데이터의 깊이를 의미합니다. 흑백 이미지는 밝기 정보만 있으므로 1개의 채널을, 컬러이미지는 빛의 3원색(RGB)를 가지므로 3개의 채널을 갖습니다.
- 특성 맵 (Feature Map): 입력 데이터에 필터를 적용(합성곱 연산)하여 얻어낸 결과물입니다. 원본 이미지에서의 특징 패턴이 어디에 있는지를 압축해서 나타낸 지도입니다.
- 출력 (Output): 신경망을 모두 거친 후 나오는 최종 결과이며, 주로 입력된 이미지가 어떤 클래스(예: 개, 고양이, 자동차 등)에 속하는지에 대한 확률값 형태입니다.
2. 합성곱 연산의 핵심 요소
- 필터(Filter) / 커널(Kernel) : 이미지에서 특정 특징을 찾아내는 작은 행렬 형태의 돋보기. 엄밀히 말하면 각 채널에 적용되는 커널들의 모임이 하나의 필터
- 합성곱 연산 (Convolution Operation): 필터를 입력 데이터 위로 일정 간격씩 이동시키며, 겹치는 부분의 숫자들을 각각 곱하고 모두 더하는 수학적 과정. 이 연산을 통해 이미지의 특징을 추출한다. 이미지뿐만 아니라 자연어 처리나 음성 인식에도 넓게 사용 됨.
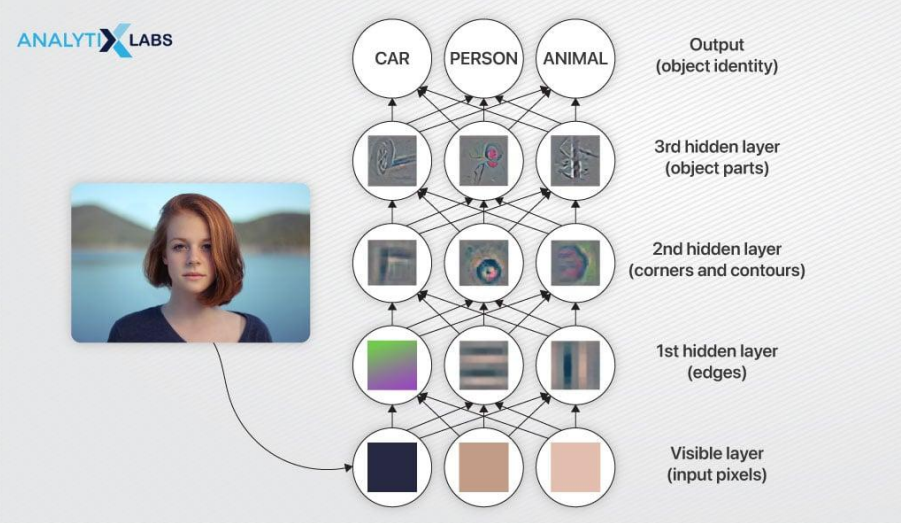
- 패턴 : 필터가 찾아내고자 하는 이미지의 시각적 특징. 모델의 초기층에서는 선, 모서리 같은 단순한 패턴을 찾고, 깊은 층으로 갈수록 눈, 코, 바퀴와 같은 복잡한 데이터를 인식
- 파라미터(Parameter) : 모델이 학습 과정을 통해 스스로 정밀하게 깎아나가야 하는 값 (가중치와 편향)입니다. CNN에서는 필터 내부의 숫자(행렬 값)들이 바로 파라미터가 되며, 이 숫자들이 변하면서 더 정확한 패턴을 찾게 됩니다.
이미지 데이터 구성요소
Convolution Filter
이미지 - FCN(Fully Connencted Network) 학습?!
FCN으로는 한계가 있다. 이유는,
1. 파라미터 수로 인한 문제
- 모든 픽셀을 연결하기 때문에 파라미터 수가 폭발적으로 생성 됨
결과적으로,
- 과적합의 위험으로, 일반화 성능이 저하됨
- 계산 비용이 증가하여, 학습 및 추론 속도가 저하됨
- 확장정이 낮음 -> 고해상도 이미지 처리에 비효율적
(예 : 1024 X 1024 X 3 이미지가 있다면, 3백만 입력 노드 필요)
2. 지역 정보 손실 (Local Information Loss)
- 픽셀 간 공간적인 구조 (예 : 인접 픽셀의 관계) 반영이 불가
- 이미지를 1차원 벡터로 변환 -> 패턴(예) 가장자리, 모서리 학습이 어려움
그렇다면, 사람은 어떻게 이미지를 인식할까?
LGN (Lateral Geniculate Nucleus)의 약자로, 한국어로는 외측슬상핵이라고 합니다.
이것은 시각 정보를 뇌로 전달하는 중요한 역할을 하는 뇌의 부분입니다.
이 LGN은 Features( edges and lines -> shapes -> objects -> faces ) 인식을 한다.
CNN 특징
1. 부분 연결
- 완전 연결층의 모든 노드 연결 방식 대체
- 전체 이미지를 작은 지역부터 점진적 학습
- 지역적 정보를 효과적으로 학습
2. 가중치 공유
- 동일한 필터(커널)을 이미지 전체에 적용
- 파라미터 수를 줄여 계산 효율성 향상
3. 계층적 특징 표현
- 입력과 가까운 하위 레이어에서 단순한 선형을 학습
- 출력에 가까운 상위 레이어에서 추상적이고 복잡한 특징을 학습
- 저수준에서 고수준으로 계층적 특징 표현이 가능
Padding

Channel
Receptive Field
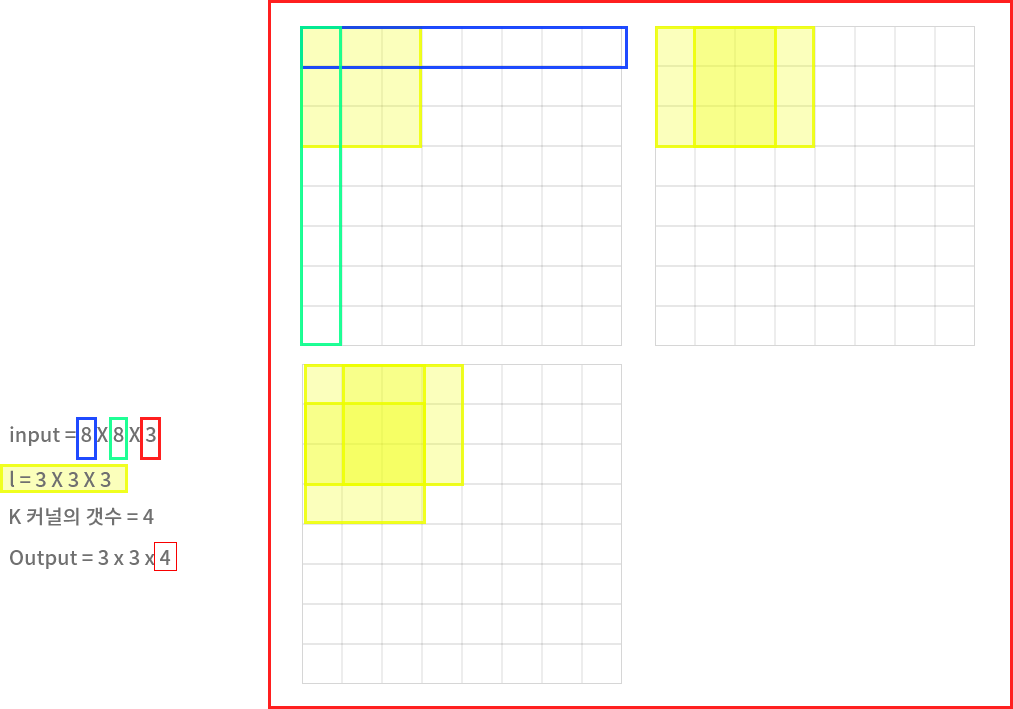
입력 이미지의 어느 범위를 바라보는지 의미한다.
Pooling Layer
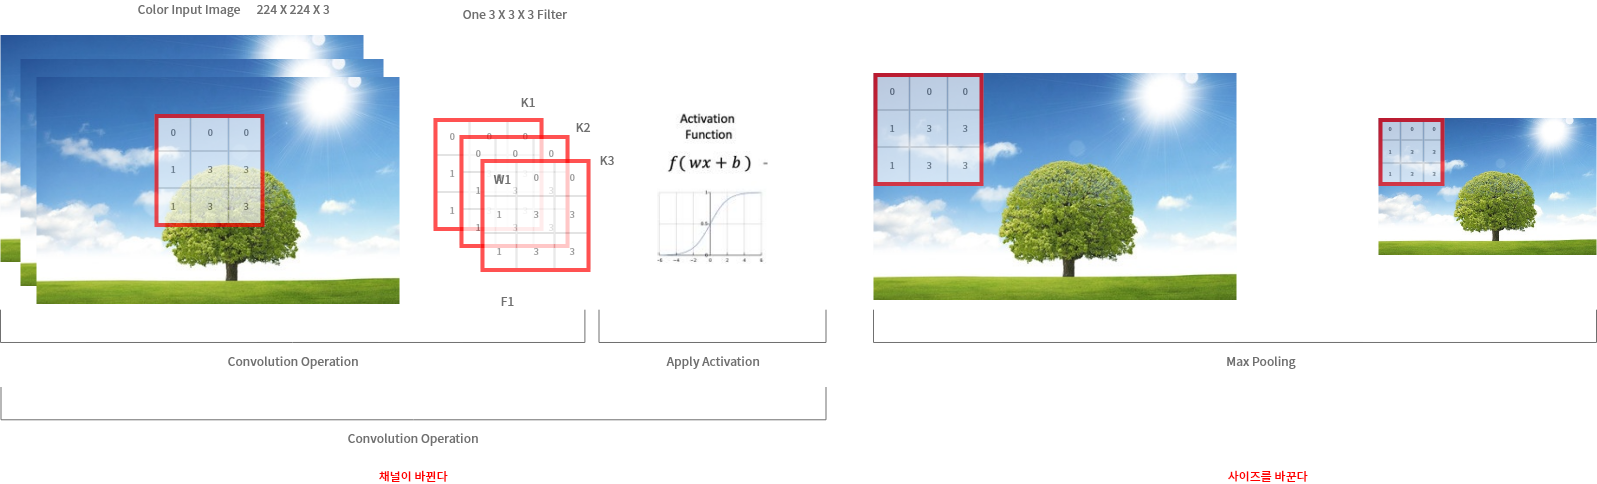
- 특징 맵의 차원을 축소하여 계산량을 감소
- 공간적 불변성을 증가시켜 작은 변화에도 강한 특지이을 학습
- 피처맵의 사이즈를 줄여서 Receptive Field를 넓힘 -> 점점 추상화 시킨다.
- 2X2를 주로 사용 3X3은 거의 사용하지 않는다.
- 풀링 크기와 스트라이드 크기를 동일하게 설정하여 차원 축소 효과 극대화
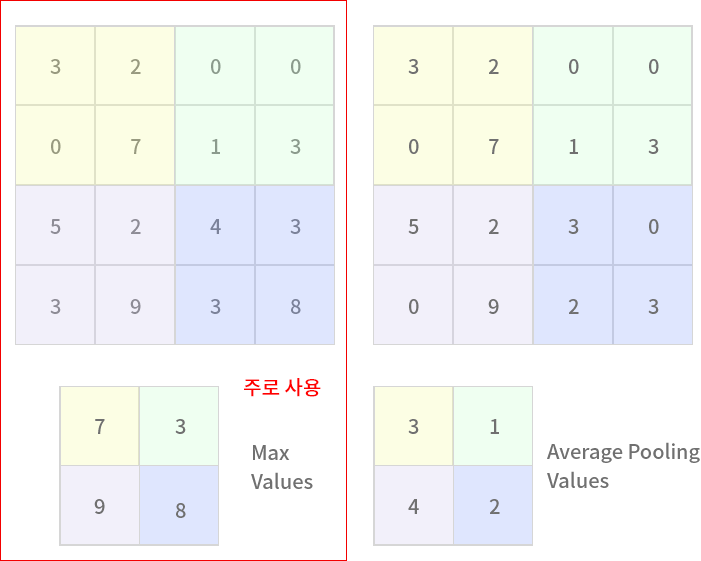
맥스풀링 (Max pooling)
- 윈도우 내 가장 큰 값 선택
- 가장 두드러진 특징을 강조 -> 날카로운 엣지 패턴 보존
- 강한 특징 정보는 유지, 약한 신호는 사라질 수 있다.
- 특정한 위치보다 존재 유무에 민감
- 일반적인 CNN 특징 추출 ( 분류, 객체 탐지)
에버리지 풀링 (Average Pooling)
- 윈도우 내 모든 값의 평균 계산 (요약)
- 영역 전체를 부드럽게 요약 -> 전반적 통계치 유지
- 모든 특징이 부분적으로 반영되지만, 값이 희석될 가능성 있음
- 평균이므로 극단값에 둔감 -> 출력이 매끄럽고 노이즈 저항이 높음
- 글로벌 Average Pooling 과적합 완화
공간적 불변성 (Positional Invariance)
이미지 내 특정한 특징이 약간 이동하거나 위치가 변해도 그 특징을 인식할 수 있는 능력
Pooling Layer 장점 :
- 계산량 감소 => 모델 학습 속도 향상
- 과적합 방지 => 더 일반화된 특징 학습
- 위치 불변성 강화 => 작은 변형에도 강한 특징 유지
단점 :
- 정보 손실 가능성 => 중요한 세부 정보가 사라질 수 있음
- 객체의 워치 정보 손실 => 공간적 정밀도가 낮아질 가능성 있음
- 고정된 연산 방식 => 모든 데이터에 최적화되지 않을 수 있음